Matt Pocock Skills : de la spécification au code
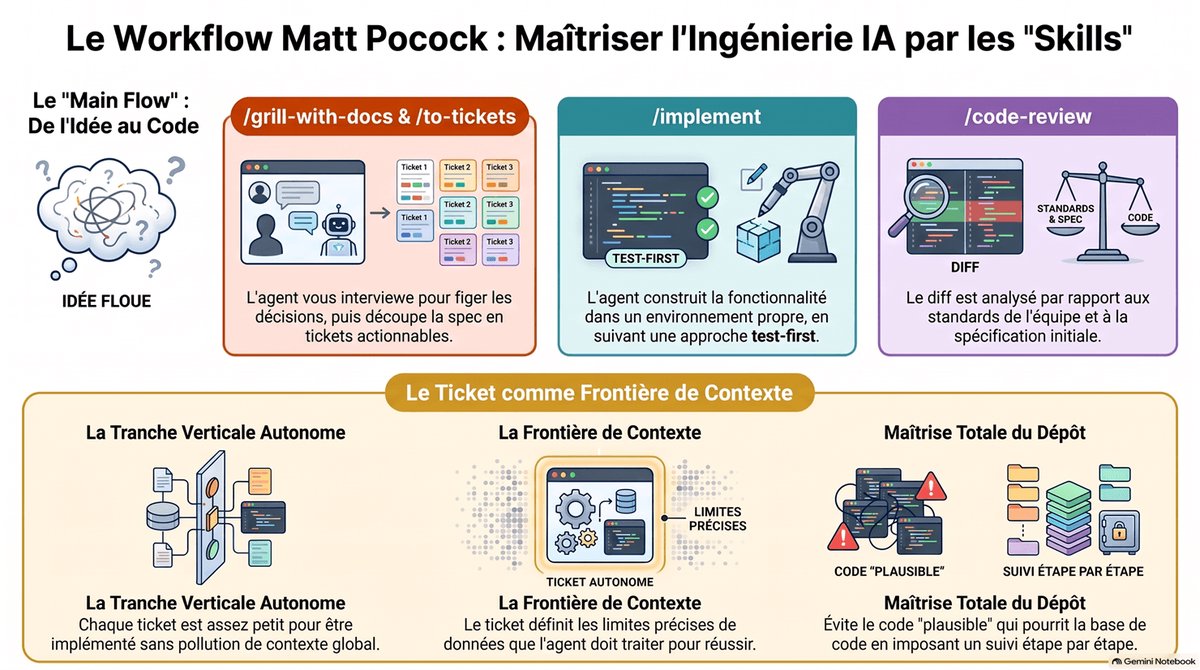
En résumé
- J'ai utilisé les Matt Pocock Skills pour développer une application web complète à partir d'une spécification déjà écrite.
- Le découpage en tickets verticaux donne à chaque session d'implémentation un périmètre clair et vérifiable.
- Le résultat m'a surtout surpris par la continuité entre spécification, code, tests et revue.
J’ai utilisé les Matt Pocock Skills pour développer une application web complète à partir d’une spécification déjà écrite. Mon retour tient en peu de mots : le résultat m’a franchement surpris, surtout par la continuité entre le besoin initial, les tickets, le code, les tests et la revue finale.
Je teste régulièrement des outils de développement assisté par IA. Générer du code vite n’est plus vraiment le sujet. Le point difficile arrive après quelques milliers de lignes, quand le contexte s’allonge, que certaines décisions ont été prises trois sessions plus tôt et que l’agent commence à réinterpréter ce qui semblait pourtant clair.
Dans une migration windev ou webdev , si le code est conséquent, on peut vite être perdu dans la masse. On peut aussi se retrouver avec un code qui " fonctionne " mais qui ne correspond pas à ce que le métier attendait. Et là, ce skill permet de garder le contrôle sur ce qui a été décidé, sur ce qui est testé et sur ce qui est revu.
Sur ce test, je suis parti d’une spécification réelle (39 spécifications rédigées au format markdown). Pas d’un prompt de cinq lignes demandant de " faire une application complète “. J’avais déjà un cadre fonctionnel et une cible. J’ai ensuite utilisé le workflow suivant :
/setup-matt-pocock-skills
        |
        v
/grill-with-docs
        |
        v
/to-tickets
        |
        v
TICKETS
        |
        v
/implement
        |
        v
CODE + TESTS
        |
        v
/code-review
A la fin, mon premier mot a été assez simple : Whoa !.
Je ne vais pas transformer ce retour en benchmark artificiel. Je n’ai pas chronométré un nombre d’heures économisées et je n’ai pas calculé un pourcentage de code " meilleur “. Ce qui m’intéresse ici est plus opérationnel : pourquoi ce workflow a tenu sur une application complète, et pourquoi le résultat m’a paru beaucoup plus maîtrisé qu’une longue session de génération continue.
Un ensemble de skills, pas un prompt géant
Le dépôt de Matt Pocock présente ces skills comme de petites briques composables pour le travail d’ingénierie. C’est exactement ce que j’ai ressenti à l’usage.
Chaque commande a un rôle assez étroit. Le cadrage ne code pas. Le découpage en tickets ne rediscute pas toute l’architecture. L’implémentation reçoit un travail déjà décidé. La revue revient sur le diff et la spécification.
Cette séparation paraît presque banale. Elle change pourtant beaucoup de choses avec un agent, parce qu’elle réduit la quantité de décisions qu’il doit reprendre à chaque étape.
| Étape | Rôle principal | Ce qui doit survivre à la session |
|---|---|---|
/setup-matt-pocock-skills | Configurer le dépôt pour les autres skills | Tracker, conventions et emplacement de la documentation |
/grill-with-docs | Challenger le besoin et fixer le vocabulaire | CONTEXT.md, décisions et ADR si nécessaire |
/to-tickets | Découper le travail en tranches verticales | Tickets, dépendances et critères vérifiables |
/implement | Construire un ticket décidé | Code, tests, vérifications et commit |
/code-review | Revoir le changement par rapport au référentiel | Constats sur les standards et la spécification |
La documentation du dépôt évolue vite. Au moment de ce test, le workflow complet documenté pour un chantier multi-session est :
grill-with-docs -> to-spec -> to-tickets -> implement -> code-review
Dans mon cas, la spécification existait déjà avant le démarrage. Le skill
to-tickets
accepte une spécification, un plan ou le contexte courant. Je suis donc passé directement de la phase de grill au découpage des tickets.
Si je partais d’une idée encore en discussion, j’ajouterais /to-spec. Cette étape sert justement à figer ce qui a été décidé avant de répartir le travail sur plusieurs contextes.
1. Commencer par configurer le dépôt
La première commande que j’ai lancée dans le dépôt est :
/setup-matt-pocock-skills
Ce setup configure les éléments que les autres skills vont devoir retrouver : le tracker utilisé pour les tickets, les conventions de triage quand elles sont présentes et l’emplacement de la documentation de domaine.
C’est un détail facile à sous-estimer. Sans cette configuration, chaque nouveau contexte doit deviner où se trouvent les tickets ou comment le projet documente ses décisions. Avec elle, les étapes suivantes travaillent sur les mêmes repères.
Pour une installation basée sur le standard Agent Skills, le dépôt propose notamment :
npx skills@latest add mattpocock/skills
Le choix exact de l’agent n’est pas le point central ici. Le workflow est conçu pour être utilisé avec plusieurs environnements compatibles.
Un pré-flight très simple avant l’implémentation
Le skill /implement travaille sur la branche Git courante et la documentation précise qu’il n’en crée pas une à votre place. J’ai donc intérêt à rendre ce contrôle banal.
Sur Ubuntu 26.04, un script de ce type suffit :
#!/usr/bin/env bash
set -euo pipefail

git rev-parse --is-inside-work-tree >/dev/null

branch="$(git branch --show-current)"

if [[ -z "${branch}" ]]; then
  echo "Aucune branche Git active."
  exit 1
fi

echo "Branche courante : ${branch}"
echo
echo "État du dépôt :"
git status --short

echo
echo "Point de départ récent :"
git log -1 --oneline
Ce n’est pas sophistiqué. C’est justement l’intérêt. Avant de lancer un agent qui peut modifier plusieurs fichiers, exécuter les tests et committer, je veux savoir exactement où je me trouve.
2. /grill-with-docs : faire travailler l’agent avant le code
La phase /grill-with-docs m’a intéressé parce qu’elle traite un problème que je rencontre souvent : une spécification peut être correcte et malgré tout contenir des mots dont le sens n’est pas assez précis pour le code.
Le skill documenté ne déroule pas un questionnaire massif. Il pose les questions une par une, cherche à stabiliser le vocabulaire du projet et écrit les termes résolus dans CONTEXT.md. Les décisions difficiles à inverser peuvent être consignées sous forme d’ADR.
La
documentation de grill-with-docs
insiste sur ce point : le résultat du cadrage doit laisser une trace utilisable par les sessions suivantes.
C’est là que le mécanisme devient intéressant sur une application complète.
Une conversation seule est fragile. On finit par la compacter, la fermer ou repartir dans une nouvelle fenêtre. Le vocabulaire documenté, lui, reste dans le dépôt. Un nom métier validé pendant le cadrage peut ensuite se retrouver dans les tickets, les fichiers, les fonctions et les tests.
Je ne cherche pas à produire un dictionnaire de cinquante pages. Quelques termes bien posés valent largement mieux qu’une explication différente à chaque session.
3. /to-tickets : le découpage qui a changé la suite
Après le grill, j’ai lancé :
/to-tickets
C’est probablement l’étape qui m’a le plus fait changer de perspective.
Le skill ne cherche pas seulement à faire une liste de tâches. Il découpe le travail en tranches verticales, des tracer bullets. Chaque ticket doit traverser les couches nécessaires pour produire un comportement vérifiable.
Un mauvais découpage ressemble souvent à ceci :
Ticket 1 : créer toutes les tables
Ticket 2 : créer toutes les API
Ticket 3 : créer toute l'interface
Ticket 4 : ajouter les tests
Le problème arrive vite. Aucun des premiers tickets ne permet de vérifier réellement un parcours utilisateur. On accumule des couches incomplètes et on repousse la validation.
Le découpage vertical cherche plutôt une forme de ce genre :
Ticket 3 : permettre la création d'un élément métier

- stockage minimal nécessaire
- règle métier associée
- action ou endpoint
- interface du parcours
- validation des erreurs
- tests du comportement
- dépendances : ticket 1
Le ticket est plus petit, mais il traverse ce qu’il faut pour être démontrable.
La documentation de
to-tickets
prévoit aussi les dépendances bloquantes entre tickets. Sur un projet plus long, cela donne un ordre d’exécution qui ne repose pas sur la mémoire de la conversation.
Il y a un autre effet, plus terre-à-terre : un ticket bien dimensionné devient une unité de contexte.
Je peux terminer un ticket, nettoyer le contexte, ouvrir une nouvelle session et donner le ticket suivant. L’agent ne doit pas conserver mentalement toute l’histoire du projet pour savoir quoi faire.
4. /implement : exécuter ce qui a déjà été décidé
Une fois les tickets produits, j’ai lancé l’implémentation ticket par ticket.
/implement <reference-du-ticket>
Le comportement documenté de
/implement
est volontairement strict : il reçoit un ticket, une spécification ou un plan déjà décidé et se concentre sur la construction. Il ne repart pas dans une phase de conception générale.
C’est important. Un agent qui revoit l’architecture à chaque ticket peut produire des idées intéressantes, mais il finit aussi par déplacer les fondations en cours de chantier.
/implement enchaîne plusieurs boucles de contrôle :
- lecture du ticket et identification des points de jonction ;
- TDD sur les comportements prévus ;
- vérifications de types et tests ciblés pendant le travail ;
- suite de tests complète à la fin ;
- revue du changement ;
- commit sur la branche courante.
J’ai surtout apprécié le rythme ticket par ticket. Une session n’avait pas à " finir l’application “. Elle devait finir une tranche identifiable.
La documentation recommande d’ailleurs un ticket par contexte frais pour les chantiers découpés avec to-tickets. Ce n’est pas une règle cosmétique. Quand une session commence directement avec un ticket autoporteur, l’agent dépense moins d’énergie à reconstruire l’intention.
Donner une référence de ticket non ambiguë
Un point pratique mérite d’être retenu. La documentation actuelle de implement signale qu’une référence courte comme #2 peut devenir ambiguë dans un nouveau contexte.
Je préfère donc une référence complète quand le tracker le permet :
/implement owner/repository#42
ou l’URL directe du ticket.
Ce petit détail évite qu’un agent très sûr de lui résolve le mauvais #2.
5. Le code et les tests arrivent ensemble
A ce stade, le résultat commence à se distinguer d’une génération de code classique.
Les tests ne sont pas une passe que j’ajoute " si j’ai le temps " une fois l’application produite. Le workflow de implement s’appuie sur TDD aux points prévus et exécute les tests pendant la construction.
Je ne prétends pas que cela garantit un code parfait. Aucun workflow ne le fait.
Mais la boucle de retour devient beaucoup plus courte. Quand une tranche fonctionnelle est terminée, il existe déjà des éléments automatiques pour vérifier son comportement. Si le ticket suivant casse quelque chose, la régression a une chance raisonnable d’être visible immédiatement.
Sur une application web complète, cette différence est importante. Le volume de code généré par un agent peut monter très vite. Sans tests, cette vitesse devient aussi une vitesse de création d’incertitude.
Avec les tickets et les tests, j’avais un dépôt que je pouvais relire par morceaux. C’est beaucoup plus proche de la manière dont je veux maintenir un vrai projet.
6. /code-review : revoir le diff et la spécification
J’ai gardé /code-review comme étape explicite à la fin de mon workflow :
/code-review main
Le principe documenté est intéressant : la revue travaille selon deux axes distincts, les standards du code et la conformité à la spécification. Ces axes sont confiés à des sous-agents séparés avant agrégation des constats.
Ce choix évite qu’une seule lecture mélange immédiatement style, architecture et respect du besoin.
La
source du skill code-review
demande aussi un fixed point, par exemple main, un tag ou un SHA. La revue peut alors raisonner sur un diff stable :
git diff main...HEAD
C’est plus propre qu’un " regarde tout mon projet et dis-moi si c’est bien “.
Un point de friction actuel à connaître
La documentation de implement mentionne une limite dans l’enchaînement automatique avec code-review : la revue travaille sur un diff entre commits, alors que des changements encore présents uniquement dans le working tree peuvent ne pas apparaître dans ce diff.
Je préfère donc garder une revue finale explicite sur un état Git clairement identifiable. Cela me donne aussi un point de contrôle humain entre l’implémentation et l’acceptation du résultat.
Le dépôt évolue rapidement. Ce comportement peut changer. C’est une raison supplémentaire pour lire la documentation de la version installée plutôt que de considérer le workflow comme figé.
Pourquoi le résultat m’a autant surpris
Je m’attendais à un ensemble de prompts bien écrits.
J’ai trouvé quelque chose de plus structurant : une manière de faire circuler l’intention entre plusieurs contextes sans demander au modèle de tout retenir.
La spécification reste le point de départ. Le grill stabilise le langage et les décisions. Les tickets deviennent des unités d’exécution. implement construit une unité à la fois avec des boucles de test. La revue revient ensuite sur ce qui a réellement changé.
Le résultat n’est pas spectaculaire parce qu’un agent aurait " tout compris tout seul “. Il est bon parce que chaque étape réduit une classe d’ambiguïtés avant de passer à la suivante.
Sur mon test, l’application complète est arrivée au bout du workflow avec son code et ses tests. Je n’ai pas eu la sensation d’une génération massive qu’il fallait ensuite reprendre fichier par fichier pour comprendre ce qui s’était passé.
C’est ce point qui m’a fait dire Whoa !.
Ce que je garderais sous contrôle sur un projet client
Je ne lancerais pas pour autant ce workflow sans garde-fous sur un dépôt client.
La branche Git doit être explicite avant /implement. Les tickets doivent rester suffisamment petits pour tenir dans un contexte frais. Les tests doivent porter sur les comportements importants, pas seulement sur les fonctions faciles à tester.
La sécurité mérite également sa propre vérification. Une revue orientée conformité à la spec ne remplace pas un audit de contrôle d’accès, de gestion des secrets, de validation d’entrée ou de dépendances.
Enfin, je garderais une validation humaine sur les décisions d’architecture. Le workflow est très bon pour exécuter une décision déjà posée. Il ne doit pas devenir une raison pour arrêter de décider.
Pour une équipe, j’ajouterais aussi des règles simples dans la CI :
#!/usr/bin/env bash
set -euo pipefail

npm ci
npm run typecheck
npm test
npm run build
A adapter évidemment au projet réel. L’idée reste la même : ce que l’agent vérifie localement doit pouvoir être rejoué de manière déterministe hors de sa session.
Définitions utiles
Skill d’agent
Un skill est une procédure spécialisée mise à disposition d’un agent. Il décrit quand intervenir, quelles étapes suivre, quels outils utiliser et quels livrables produire.
CONTEXT.md
Dans ce workflow, CONTEXT.md sert à conserver le vocabulaire de domaine partagé. Les sessions suivantes peuvent retrouver les termes déjà définis au lieu de les réinterpréter.
ADR
Un Architecture Decision Record documente une décision d’architecture qui mérite de survivre au contexte où elle a été prise. Il conserve notamment la décision et les raisons qui l’ont motivée.
Tracer bullet
Un tracer bullet est une tranche verticale petite mais complète. Elle traverse les couches nécessaires à un comportement vérifiable au lieu de livrer uniquement une couche technique isolée.
Fixed point
Le fixed point est la référence Git utilisée pour calculer le changement à revoir : branche, tag ou commit connu. code-review compare ensuite ce point à HEAD.
Références techniques
Conclusion
Ce test des Matt Pocock Skills m’a donné une vision beaucoup plus crédible du développement assisté par agent sur un projet complet.
Je retiens surtout la discipline de passage entre les étapes. Une spécification n’est pas abandonnée après le premier prompt. Elle est transformée en langage partagé, puis en tickets suffisamment petits pour être exécutés, testés et revus.
Pour EloNeva, l’intérêt est évident sur les applications métier que nous développons ou modernisons. Les agents peuvent accélérer une partie importante de l’exécution, à condition de leur donner des frontières claires et des boucles de vérification reproductibles.
Je continuerai à garder l’architecture, la sécurité et la validation métier sous contrôle humain. Pour transformer une spécification déjà cadrée en tranches de code testables, ce workflow a gagné sa place dans ma boîte à outils.