HFSQL vers PostgreSQL : pièges de migration WinDev
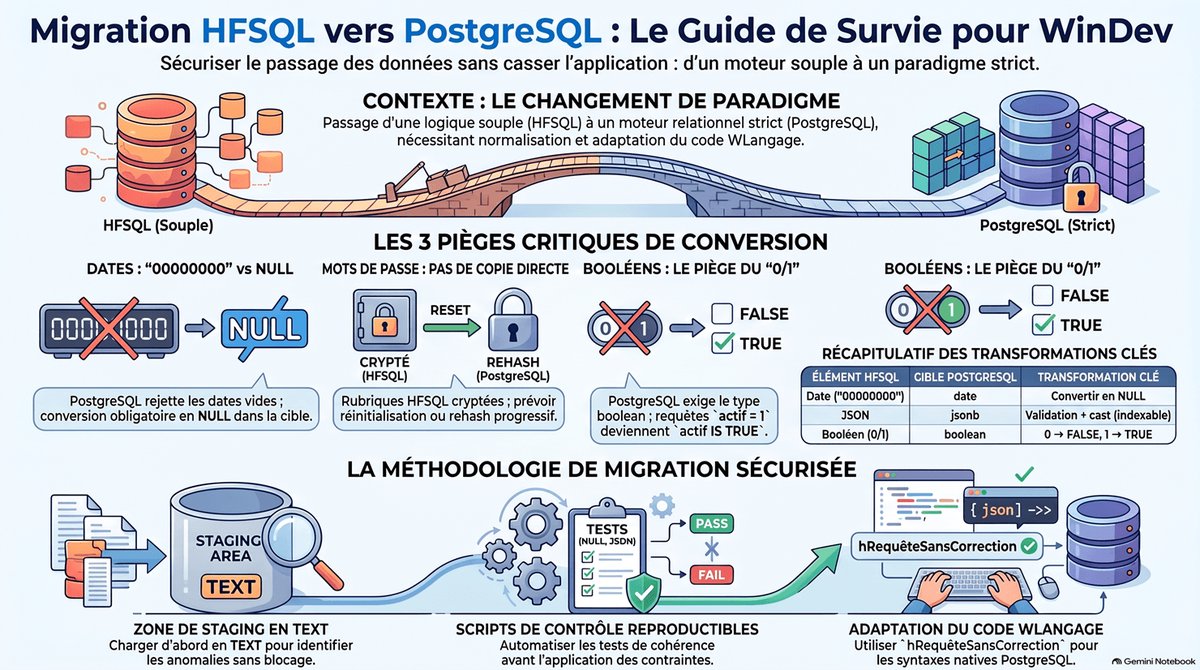
En résumé
- Les dates vides HFSQL comme 00000000 ou chaîne vide doivent être normalisées avant d'entrer dans une colonne date PostgreSQL.
- Une rubrique Mot de passe HFSQL n'est pas une chaîne exportable : la stratégie d'authentification doit faire partie de la migration.
- JSON et booléens se migrent bien, mais les requêtes WinDev doivent être revues pour respecter les types et opérateurs PostgreSQL.
Le constat
Oui, une migration HFSQL vers PostgreSQL peut casser une application WinDev alors que les tables semblent avoir été recréées correctement. Les problèmes arrivent souvent sur quatre types qui paraissent banals dans l’analyse : les dates vides, les rubriques Mot de passe, le JSON et les booléens.
Le schéma SQL n’est qu’une partie du travail. Une application WinDev ancienne transporte aussi des conventions de données. Une date non renseignée peut être testée avec "" ou 00000000. Un booléen peut être comparé à 1. Une rubrique JSON peut être interrogée avec les fonctions SQL comprises par HFSQL. Une rubrique Mot de passe n’est pas un VARCHAR amélioré.
PostgreSQL est plus strict sur plusieurs de ces points. C’est plutôt une bonne chose. Mais si on branche directement l’application dessus, les erreurs apparaissent dans les imports, les requêtes, puis dans les écrans où personne ne pensait encore toucher au stockage.
Je traite donc ce type de migration en deux temps : faire passer les données par une zone de staging, puis adapter les usages WinDev qui reposent sur les conventions HFSQL.
| Sujet | Habitude rencontrée côté HFSQL / WinDev | Cible PostgreSQL | Risque principal |
|---|---|---|---|
| Date vide | "", 00000000, test Val(Date)=0 | date + NULL | import rejeté ou logique métier modifiée |
| Mot de passe | rubrique HFSQL dédiée | pas d’équivalent direct | authentification impossible après copie naïve |
| JSON | rubrique JSON + fonctions SQL HFSQL | json ou jsonb | opérateurs et représentation différents |
| Booléen | 0/1, comparaisons numériques | boolean | actif = 1 ne correspond plus au type |
1. Avant la migration : chercher les conventions, pas seulement les colonnes
Exporter l’analyse WinDev et produire un CREATE TABLE PostgreSQL donne une première vue. Elle ne suffit pas.
Je cherche aussi les usages dans le code :
- comparaisons de dates avec
""ou00000000, - appels à
DateValide,Valou conversions de chaînes autour d’une date, - requêtes contenant
= 1,= 0,<> 1, - fonctions
JSON_VALUE,JSON_QUERY,JSON_EXISTS, - affectations ou comparaisons sur des rubriques Mot de passe,
- traitements qui supposent qu’une valeur vide est différente de
NULL.
Sur un projet dont les sources ou exports SQL sont disponibles sous forme texte, un passage avec ripgrep fait déjà remonter beaucoup de choses :
#!/usr/bin/env bash
set -euo pipefail

ROOT="${1:-.}"

rg -n \
  --glob '*.sql' \
  --glob '*.txt' \
  --glob '*.wl' \
  '00000000|JSON_VALUE|JSON_QUERY|JSON_EXISTS|=\s*[01]\b|<>\s*[01]\b|MotDePasse' \
  "$ROOT"
Sur un projet WinDev stocké uniquement dans son format natif, je complète avec la recherche globale de l’éditeur. Ce n’est pas la partie la plus intéressante du chantier, mais elle évite de découvrir le comportement de 00000000 en recette finale.
2. Date vide : 00000000 et "" ne sont pas des dates PostgreSQL
Dans du code WinDev, une date vide est souvent représentée ou testée avec 00000000. On rencontre aussi des affectations ou comparaisons avec une chaîne vide. Cette convention peut très bien vivre pendant des années dans une application HFSQL.
PostgreSQL attend une valeur de date valide pour une colonne date. Le moteur accepte plusieurs formats d’entrée, dont YYYYMMDD, mais 00000000 n’est pas une date et '' non plus.
Le premier import direct finit alors avec ce genre de logique :
INSERT INTO client (date_fin_validite)
VALUES ('00000000');
La ligne n’entre pas. Et c’est préférable à une conversion silencieuse.
La bonne cible est généralement NULL
Si la valeur signifie " aucune date “, je la transforme en NULL.
Le changement paraît simple. Il faut ensuite revoir les tests dans l’application, parce que SQL traite NULL avec une logique à trois états.
Une condition historique comme :
WHERE date_fin_validite = ''
devient :
WHERE date_fin_validite IS NULL
Et dans le code WLangage, il faut arrêter de faire dépendre le métier d’une représentation comme 00000000.
Passer par une table de staging en texte
Je charge d’abord la valeur d’origine dans une colonne text. Cela permet d’identifier les anomalies sans interrompre tout l’import.
CREATE TABLE stg_client (
    id_client bigint,
    date_fin_validite_raw text
);
On peut ensuite compter les valeurs vides connues :
SELECT
    count(*) FILTER (
        WHERE btrim(date_fin_validite_raw) IN ('', '00000000')
    ) AS dates_vides,
    count(*) FILTER (
        WHERE btrim(date_fin_validite_raw) NOT IN ('', '00000000')
          AND NOT pg_input_is_valid(btrim(date_fin_validite_raw), 'date')
    ) AS dates_invalides
FROM stg_client;
Puis alimenter la table cible :
INSERT INTO client (id_client, date_fin_validite)
SELECT
    id_client,
    CASE
        WHEN btrim(date_fin_validite_raw) IN ('', '00000000') THEN NULL
        WHEN pg_input_is_valid(btrim(date_fin_validite_raw), 'date')
            THEN btrim(date_fin_validite_raw)::date
        ELSE NULL
    END
FROM stg_client;
Je ne laisse pas les dates invalides disparaître sans trace. Avant l’INSERT, je les exporte dans un rapport de rejet :
SELECT id_client, date_fin_validite_raw
FROM stg_client
WHERE btrim(date_fin_validite_raw) NOT IN ('', '00000000')
  AND NOT pg_input_is_valid(btrim(date_fin_validite_raw), 'date');
Une valeur comme 20240231 n’est pas une " date vide “. C’est une donnée incorrecte. Les deux cas ne doivent pas finir dans le même sac sans décision métier.
Attention aux dates sentinelles
Certaines applications utilisent 00000000 pour " jamais “, " non renseigné “, " pas encore calculé " ou " pas de date de fin “. Ce sont déjà quatre sens différents.
Les convertir tous en NULL peut être acceptable. Ou pas.
Avant de normaliser, je vérifie ce que fait réellement le code :
SI CLIENT.DateFin = "" ALORS
    // Pas de date de fin
FIN

SI CLIENT.DateRelance = "00000000" ALORS
    // Relance jamais calculée
FIN
Si deux comportements métier distincts utilisent la même valeur sentinelle, la migration est un bon moment pour les séparer. Par exemple avec une colonne de statut explicite plutôt qu’une nouvelle date artificielle.
3. Rubrique Mot de passe : il n’existe pas de conversion directe
La rubrique Mot de passe de HFSQL est particulière. Elle a été conçue pour ne pas conserver le mot de passe en clair : la valeur est salée et hachée, et le mot de passe original n’est pas relu comme une chaîne ordinaire.
C’est précisément ce qu’on attend d’un stockage de mot de passe.
Le problème arrive quand un outil de migration traite la colonne comme un texte ou un binaire quelconque et imagine qu’il suffira de la recopier dans PostgreSQL.
Il n’existe pas de type PostgreSQL " Mot de passe HFSQL " capable de reprendre ce comportement automatiquement.
Trois stratégies réalistes
La première est la plus simple : forcer une réinitialisation des mots de passe lors de la bascule. On migre les comptes, les rôles et les identifiants, mais pas le secret existant.
La deuxième est une migration progressive. Pendant une période courte, l’application valide encore le mot de passe contre HFSQL. Si l’authentification réussit, elle calcule un nouveau hash selon la politique retenue pour la cible, l’enregistre dans PostgreSQL puis marque le compte comme migré.
Le principe ressemble à ceci :
1. L'utilisateur saisit son mot de passe.
2. Le compte n'a pas encore de hash PostgreSQL.
3. L'application vérifie le mot de passe via le mécanisme HFSQL existant.
4. Si la vérification réussit, elle crée le nouveau hash PostgreSQL.
5. Les connexions suivantes n'utilisent plus HFSQL pour ce compte.
La troisième consiste à conserver temporairement un service d’authentification adossé à HFSQL. Je la réserve aux migrations où une coupure franche est impossible. Il faut une date de fin. Sinon on maintient deux systèmes d’authentification pour longtemps, ce qui devient vite une dette de plus.
Ce que je n’essaie pas de faire
Je n’exporte pas une représentation interne HFSQL pour la remettre dans une colonne text nommée password_hash sans savoir la vérifier côté PostgreSQL.
Je ne remplace pas non plus une rubrique Mot de passe par un simple SHA-256(mot_de_passe). Pour un mot de passe utilisateur, il faut une fonction de dérivation adaptée, avec coût de calcul et sel. La stratégie doit être définie avant la bascule.
Sur une application métier WinDev, cette décision doit arriver tôt. Découvrir la veille du passage en production que les utilisateurs ne peuvent plus s’authentifier est un incident de migration, pas un détail de base de données.
4. JSON : le type existe des deux côtés, pas les mêmes usages
HFSQL dispose de rubriques JSON natives et vérifie la syntaxe lors de l’écriture. Les requêtes peuvent utiliser des fonctions comme JSON_VALUE, JSON_QUERY et JSON_EXISTS.
PostgreSQL propose deux types : json et jsonb.
Pour une application métier qui filtre souvent dans le document, je pars généralement sur jsonb. Il évite de reparcourir le texte à chaque traitement et peut être indexé. Il modifie toutefois la représentation interne : espaces, ordre des clés et doublons de clés ne sont pas conservés de la même manière que dans le texte d’origine.
Si le JSON est signé, hashé, comparé caractère par caractère ou transmis tel quel à un autre système, je vérifie ce point avant de choisir jsonb.
Charger d’abord le JSON en texte
Même logique que pour les dates :
CREATE TABLE stg_parametre (
    id_parametre bigint,
    contenu_raw text
);
Détection des valeurs qui ne passent pas en jsonb :
SELECT id_parametre, contenu_raw
FROM stg_parametre
WHERE contenu_raw IS NOT NULL
  AND NOT pg_input_is_valid(contenu_raw, 'jsonb');
Chargement final :
INSERT INTO parametre (id_parametre, contenu)
SELECT
    id_parametre,
    CASE
        WHEN contenu_raw IS NULL OR btrim(contenu_raw) = '' THEN NULL
        ELSE contenu_raw::jsonb
    END
FROM stg_parametre
WHERE contenu_raw IS NULL
   OR btrim(contenu_raw) = ''
   OR pg_input_is_valid(contenu_raw, 'jsonb');
Les requêtes doivent être portées
Une requête HFSQL peut contenir :
SELECT JSON_VALUE(Parametres, '$.facturation.mode')
FROM Societe;
Avec une colonne PostgreSQL jsonb, une écriture idiomatique devient par exemple :
SELECT parametres #>> '{facturation,mode}'
FROM societe;
Pour rechercher une valeur :
SELECT *
FROM societe
WHERE parametres @> '{"facturation":{"mode":"mensuel"}}'::jsonb;
Et si cette recherche devient fréquente :
CREATE INDEX idx_societe_parametres_gin
ON societe
USING gin (parametres);
Le piège n’est donc pas le stockage du JSON. C’est de croire que les requêtes SQL HFSQL continueront à fonctionner parce que le nom de la colonne n’a pas changé.
WinDev peut aussi corriger la requête
Avec un accès natif PostgreSQL, certaines requêtes contiendront des opérateurs spécifiques au moteur. Dans ce cas, il faut vérifier le mode d’exécution côté WinDev et ne pas laisser le moteur de vérification HFSQL réécrire ou refuser une syntaxe PostgreSQL.
Sur les requêtes concernées, l’option hRequêteSansCorrection fait partie des points à tester. Je préfère l’activer seulement là où la requête utilise réellement une syntaxe native. Une migration devient plus facile à maintenir quand les exceptions restent visibles.
5. Booléens : le 0/1 qui survit dans toutes les requêtes
Les booléens donnent souvent une impression de compatibilité parfaite. Dans WinDev, on manipule depuis longtemps Vrai et Faux, et beaucoup de bases historiques les exposent aussi comme 0 et 1.
PostgreSQL possède un vrai type boolean.
Son parseur accepte notamment les représentations textuelles '1' et '0' comme valeurs d’entrée. Cela ne signifie pas qu’un entier et un booléen deviennent interchangeables dans toutes les expressions SQL.
Cette requête héritée est typique :
SELECT *
FROM client
WHERE actif = 1;
Avec actif boolean, je la réécris :
SELECT *
FROM client
WHERE actif IS TRUE;
Ou, si NULL n’est jamais autorisé :
SELECT *
FROM client
WHERE actif;
Même sujet pour le faux :
WHERE actif IS FALSE
Transformer les données 0/1 explicitement
Dans le staging, je garde encore une colonne texte ou entière selon la source :
CREATE TABLE stg_client_bool (
    id_client bigint,
    actif_raw text
);
Puis :
INSERT INTO client (id_client, actif)
SELECT
    id_client,
    CASE btrim(actif_raw)
        WHEN '1' THEN TRUE
        WHEN '0' THEN FALSE
        WHEN '' THEN NULL
        ELSE NULL
    END
FROM stg_client_bool;
Comme pour les dates, je sors les valeurs inattendues avant l’import :
SELECT id_client, actif_raw
FROM stg_client_bool
WHERE btrim(actif_raw) NOT IN ('0', '1', '');
J’ai déjà vu des colonnes censées être booléennes contenir -1, 2 ou une chaîne issue d’un ancien export. PostgreSQL force à décider ce que ces valeurs veulent dire. Ce n’est pas du temps perdu.
Le NULL change aussi le comportement
Un booléen PostgreSQL peut être TRUE, FALSE ou NULL si la colonne l’autorise.
Si le métier n’a que deux états, je préfère le dire dans le schéma :
ALTER TABLE client
ALTER COLUMN actif SET DEFAULT FALSE;

UPDATE client
SET actif = FALSE
WHERE actif IS NULL;

ALTER TABLE client
ALTER COLUMN actif SET NOT NULL;
On évite ensuite une partie des tests ambigus dans WinDev.
6. Construire une table de correspondance des types avant de toucher à l’analyse
Je garde une table de décision simple dans le dossier de migration. Elle sert autant au développement qu’à la recette.
| HFSQL / usage WinDev | PostgreSQL proposé | Transformation | Tests à prévoir |
|---|---|---|---|
Date avec 00000000 / "" | date NULL | valeurs vides → NULL | tri, filtres, calculs d’échéance |
| Mot de passe | colonne de hash selon nouvelle politique | reset ou migration progressive | login, reset, comptes inactifs |
| JSON | jsonb le plus souvent | validation + cast | requêtes, index, sérialisation |
| Booléen 0/1 | boolean | 0 → FALSE, 1 → TRUE | filtres, exports, états |
| Texte vide utilisé comme " absent " | text ou NULL selon métier | décision au cas par cas | recherche et contraintes |
| Identifiant automatique | bigint generated ... ou identity | conserver ou recalculer | FK, séquences, reprise |
Cette étape prend peu de temps par rapport à une reprise après bascule.
7. Faire une migration reproductible sous Ubuntu 24.02
Je ne lance pas une suite de commandes manuelles dans psql puis j’espère pouvoir la rejouer trois semaines plus tard.
Le minimum est un script qui échoue dès qu’une commande SQL échoue et qui produit les comptages de contrôle.
Exemple compatible Ubuntu 24.02 :
#!/usr/bin/env bash
set -euo pipefail

: "${PGSERVICE:?Définir PGSERVICE vers le service PostgreSQL de migration}"

psql --set=ON_ERROR_STOP=1 <<'SQL'
BEGIN;

-- Contrôle des dates
SELECT
    count(*) AS total,
    count(*) FILTER (
        WHERE btrim(date_fin_validite_raw) IN ('', '00000000')
    ) AS vides,
    count(*) FILTER (
        WHERE btrim(date_fin_validite_raw) NOT IN ('', '00000000')
          AND NOT pg_input_is_valid(btrim(date_fin_validite_raw), 'date')
    ) AS invalides
FROM stg_client;

-- Contrôle des booléens
SELECT actif_raw, count(*)
FROM stg_client_bool
GROUP BY actif_raw
ORDER BY actif_raw;

-- Contrôle JSON
SELECT count(*) AS json_invalides
FROM stg_parametre
WHERE contenu_raw IS NOT NULL
  AND btrim(contenu_raw) <> ''
  AND NOT pg_input_is_valid(contenu_raw, 'jsonb');

ROLLBACK;
SQL
Le ROLLBACK est volontaire ici : ce script ne modifie rien. Il sert de garde-fou avant la vraie phase de transformation.
Pour les chargements réels, je sépare les fichiers :
migration/
├── 00_schema.sql
├── 10_staging.sql
├── 20_import_raw.sql
├── 30_transform.sql
├── 40_constraints.sql
├── 50_indexes.sql
└── 90_checks.sql
Le jour où il faut rejouer la migration sur une copie fraîche, cette organisation fait gagner beaucoup plus de temps qu’elle n’en coûte.
8. Adapter le code WinDev avant la bascule
La base peut être parfaitement migrée et l’application encore fausse.
Je passe au minimum sur ces familles de requêtes.
Tests de dates
Avant :
SI CLIENT.DateFin = "" OU CLIENT.DateFin = "00000000" ALORS
    // ...
FIN
Après migration, l’idée métier doit devenir " date absente “. Le test exact dépend de la façon dont le connecteur natif remonte NULL dans le projet. C’est ce comportement qu’il faut valider dans une petite fenêtre de test, pas supposer à partir de l’ancien code.
SQL booléen
Avant :
SELECT *
FROM CLIENT
WHERE Actif = 1;
Après :
SELECT *
FROM client
WHERE actif IS TRUE;
SQL JSON
Avant :
SELECT JSON_VALUE(Parametres, '$.facturation.mode')
FROM SOCIETE;
Après :
SELECT parametres #>> '{facturation,mode}'
FROM societe;
Authentification
Avant la bascule, je définis noir sur blanc :
- quels comptes doivent continuer à fonctionner le premier jour,
- quels utilisateurs peuvent réinitialiser leur mot de passe,
- combien de temps une éventuelle validation HFSQL reste disponible,
- à partir de quelle date HFSQL n’est plus consulté pour l’authentification.
Sans cette règle, la rubrique Mot de passe devient un point bloquant tardif.
9. Les tests qui trouvent vraiment les problèmes
Les tests de migration ne doivent pas seulement comparer le nombre de lignes.
Je garde ces contrôles :
-- Comptage global
SELECT count(*) FROM client;

-- Dates absentes
SELECT count(*) FROM client WHERE date_fin_validite IS NULL;

-- Répartition booléenne
SELECT actif, count(*)
FROM client
GROUP BY actif
ORDER BY actif;

-- JSON
SELECT count(*) FROM parametre WHERE contenu IS NOT NULL;

-- Quelques valeurs métier extraites du JSON
SELECT contenu #>> '{facturation,mode}', count(*)
FROM parametre
WHERE contenu IS NOT NULL
GROUP BY 1
ORDER BY 2 DESC;
Puis je recoupe avec HFSQL sur un échantillon métier : clients clôturés, comptes actifs, documents avec paramètres JSON, utilisateurs anciens, enregistrements sans date de fin.
Le test utile est celui qui remet en cause une convention implicite. Un simple COUNT(*) ne verra jamais qu’une requête WinDev cherche encore Actif = 1.
10. Ordre de bascule que j’utilise
Je préfère une séquence courte et rejouable :
- créer le schéma PostgreSQL cible ;
- charger les données brutes dans des tables de staging ;
- produire les rapports d’anomalies ;
- faire valider les règles de conversion ;
- transformer vers les tables finales ;
- poser les contraintes et index ;
- lancer les contrôles SQL ;
- exécuter la recette WinDev sur PostgreSQL ;
- faire une reprise finale des données modifiées depuis le dernier chargement ;
- basculer l’application avec une procédure de retour arrière documentée.
Les contraintes viennent après le staging, pas avant. Le staging est justement là pour accueillir les données telles qu’elles existent, y compris les valeurs qu’on ne veut plus dans la cible.
Le mot de la fin
Migrer HFSQL vers PostgreSQL ne se résume pas à remplacer un moteur de base de données dans l’analyse WinDev.
Les difficultés apparaissent dans les conventions accumulées : une date vide à 00000000, un Actif = 1, une requête JSON_VALUE, une rubrique Mot de passe qu’on pensait pouvoir exporter comme les autres.
Le travail rentable consiste à rendre ces conventions visibles avant la bascule. Une zone de staging, des règles de conversion écrites et quelques contrôles SQL reproductibles évitent une bonne partie des incidents.
Pour EloNeva, c’est aussi l’intérêt d’une migration bien cadrée : PostgreSQL devient une base plus explicite et plus contrôlable, sans obliger à réécrire l’application WinDev. On corrige d’abord les incompatibilités qui comptent, puis on fait évoluer le reste avec une trajectoire lisible.