Agents fantômes : gouverner l'autonomie des IA
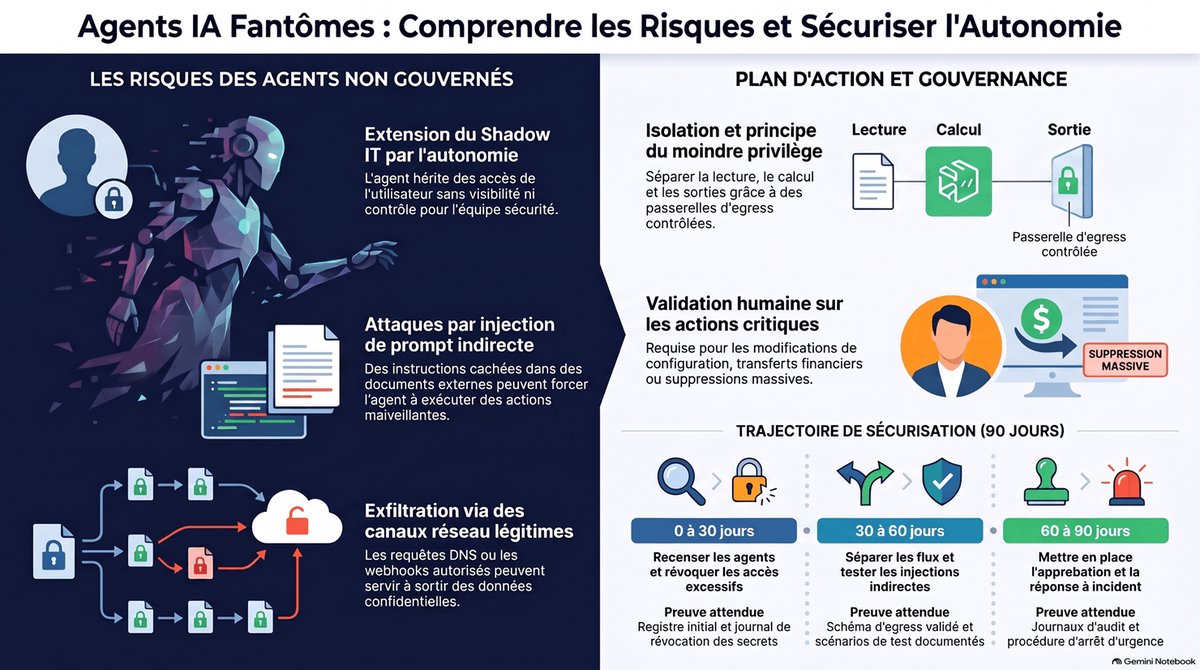
En résumé
- Un agent IA équipé d'outils peut agir sur les données et les systèmes avec les droits qu'on lui délègue.
- Les risques majeurs combinent agents non inventoriés, injection de prompt et canaux de sortie insuffisamment contrôlés.
- Registre, permissions minimales, contrôle des flux et validation humaine ciblée réduisent l'exposition.
De quoi parle-t-on ?
Un agent IA autonome est une application qui utilise un modèle pour choisir des étapes et appeler des outils : lire un fichier, interroger une base, produire du code ou envoyer un message. Pour une entreprise, son risque dépend des droits effectivement confiés à ces outils, des données auxquelles ils accèdent et des contrôles qui entourent leurs actions. Un chatbot isolé peut donner une réponse fausse. Un agent équipé d’un accès en écriture peut modifier l’ERP.
Cette différence change la manière de conduire un audit. Une équipe peut parfaitement encadrer ses API métier tout en laissant un agent installé sur un poste utiliser un jeton personnel et un canal de messagerie. Son usage n’apparaît alors dans aucun registre applicatif. Le responsable sécurité découvre parfois l’intégration au moment de renouveler un secret ou d’analyser un incident.
Le vocabulaire de " shadow AI “ désigne ces usages d’IA non gouvernés. Nous parlerons ici d’agents fantômes pour les systèmes capables d’agir sans propriétaire, permissions ni processus de validation clairement identifiés.
1. Les agents fantômes prolongent le shadow IT
Une automatisation locale peut devenir une intégration de production
Prenons une situation plausible dans une PME industrielle. Un analyste souhaite rapprocher les commandes de l’ERP, les messages du service commercial et des exports de stock. Il installe un agent sur sa machine. Pour gagner du temps, il lui donne l’accès au répertoire des exports, à une base en lecture et à son compte de messagerie.
L’outil répond au besoin. Mais personne n’a demandé quelle durée de vie ont les jetons, où les fichiers temporaires sont conservés, quelles dépendances sont chargées ni quels serveurs externes peuvent être contactés. Le problème existe même sans attaquant : les droits de l’analyste deviennent progressivement ceux de son automatisation.
Une sandbox n’est pas une frontière de confiance garantie. Elle peut limiter les processus, le système de fichiers et le réseau. Encore faut-il connaître son périmètre. Un conteneur qui monte un répertoire sensible, dispose de secrets réutilisables et peut sortir sur Internet n’est pas isolé des données qu’il contient.
Ce que l’inventaire doit capturer
Un registre utile recense l’identifiant de l’agent, son propriétaire métier, l’exploitant technique, le modèle et le fournisseur utilisés, les outils raccordés, les classes de données accessibles, les identités de service, les destinations réseau, les secrets, l’environnement et la date de révision. Il doit aussi mentionner un mécanisme d’arrêt et de révocation.
L’objectif n’est pas de conserver une simple liste de produits IA. Il faut pouvoir répondre : quel agent a accès aux données clients, peut envoyer un message et avec quel compte ?
2. L’injection de prompt devient un risque d’exécution
Un agent peut recevoir un document censé servir de donnée : courriel fournisseur, CV, ticket de support ou page web. Une instruction malveillante insérée dans ce document peut lui demander de changer de tâche. C’est une injection de prompt indirecte.
Le chemin d’attaque dépend des protections réellement déployées :
- L’agent lit un contenu non fiable afin de réaliser une tâche légitime.
- Le contenu contient une instruction destinée au modèle, distincte des données métier.
- Le modèle tente d’utiliser un outil accessible : requête, lecture de fichier ou émission d’un message.
- Si l’outil ne vérifie pas indépendamment l’autorisation, l’action peut être exécutée.
Il ne faut pas supposer qu’une injection réussit systématiquement. Il faut en revanche concevoir les outils comme si le texte produit par le modèle pouvait être erroné ou manipulé. L’OWASP décrit ce risque sous le terme Excessive Agency : trop de fonctions, trop de privilèges ou trop d’autonomie accordés à un système fondé sur un LLM.
Exfiltration : plusieurs canaux, pas une seule technique
Une entreprise peut bloquer l’accès au navigateur tout en autorisant d’autres communications. Parmi les chemins à examiner figurent :
- les requêtes DNS sortantes, dont les noms peuvent dans certaines configurations transporter une information encodée ;
- les API ou webhooks déjà approuvés, par exemple pour publier des messages dans un espace collaboratif ;
- les dépôts de code, systèmes de tickets, journaux applicatifs ou synchronisations de fichiers ;
- les appels sortants déclenchés par une bibliothèque ou une dépendance compromise.
Une fuite via DNS n’est pas automatique : le résolveur, le filtrage des domaines, les limites de taille et l’observabilité du réseau conditionnent sa faisabilité. Le cas des webhooks est plus banal. Une destination autorisée pour un usage légitime peut recevoir des données qu’elle ne devrait pas voir.
Sur une base Postgres exposée par MCP, la question se pose rapidement. Si l’agent dispose d’un outil de requêtage général, quelle règle empêche la lecture d’une table entière ? Et si une publication externe est également accessible, quelle politique empêche le croisement des deux opérations ? Le protocole d’intégration ne remplace pas le contrôle d’accès métier.
3. Réduire les droits avant de multiplier les validations
Séparer lecture, calcul et publication
Une architecture saine distingue trois zones : un connecteur aux données métier, un espace de traitement temporaire et un service de sortie. Le connecteur applique des requêtes autorisées, des filtres de périmètre et des limites de volume. L’espace de calcul ne reçoit que les éléments nécessaires. Le service de sortie décide quelles données peuvent quitter le périmètre de confiance.
Un agent n’a donc pas besoin d’un accès permanent et simultané à toute la base et à Internet. Cela ne signifie pas qu’il faille imposer un environnement air-gapped à tous les usages. Le mode hors réseau est pertinent pour des traitements particulièrement sensibles. Pour le reste, des flux strictement autorisés, une passerelle de sortie et des contrôles applicatifs peuvent répondre au besoin.
Voici un exemple illustratif de profil Compose pour un traitement local n’ayant aucun besoin réseau :
services:
  agent-analyse:
    image: registre-interne/agent-analyse@sha256:REMPLACER_PAR_DIGEST_VALIDE
    network_mode: "none"
    read_only: true
    user: "10001:10001"
    cap_drop:
      - ALL
    security_opt:
      - no-new-privileges:true
    pids_limit: 128
    mem_limit: 512m
    tmpfs:
      - /tmp:rw,noexec,nosuid,size=64m
    volumes:
      - ./donnees-filtrees:/app/input:ro
Ce profil ne peut pas accéder à une API distante et ne convient donc pas à un agent qui dépend d’un modèle cloud. Il ne remplace pas l’analyse des montages de volumes, des capacités du runtime, du noyau, de la chaîne d’approvisionnement ni la gestion des données de sortie. L’image devra être construite et vérifiée par l’équipe technique, puis épinglée sur un véritable digest.
Pour un agent devant utiliser le réseau, préférez une identité dédiée et une passerelle d’egress : contrôle de destinations, authentification, inspection adaptée aux contraintes de confidentialité, quotas et traces. Un secret de production ne doit jamais être injecté dans le contexte du modèle si un composant applicatif peut exécuter l’action à sa place.
Une validation humaine sur les opérations sensibles
Faire valider chaque lecture de fichier rend l’automatisation inutilisable. La validation humaine a du sens sur des points bien définis : premier accès à une catégorie de données sensibles, export en dehors du périmètre, modification d’une configuration, déploiement, suppression massive ou transfert financier.
L’écran de validation doit afficher l’action réelle et ses paramètres : destination, volume, objets concernés, identité et conséquences. Un bouton " Autoriser " devant un résumé généré uniquement par le modèle n’offre pas une garantie suffisante.
La validation humaine complète les politiques de sécurité. Elle ne remplace ni les règles serveur ni les droits minimaux.
4. Responsabilité : éviter les raccourcis juridiques
Un agent n’est pas une personne juridique autonome. Ses actions engagent un ensemble de responsabilités qui dépendent des faits, du contrat, du rôle de chaque acteur et du droit applicable. Il serait inexact d’affirmer que l’entreprise utilisatrice est toujours la seule responsable, ou que les fournisseurs de modèles sont systématiquement exonérés.
Pour les données personnelles, le RGPD distingue notamment responsable du traitement et sous-traitant. Si une violation présente un risque pour les droits et libertés des personnes, le responsable du traitement doit en principe notifier l’autorité compétente sans retard injustifié, si possible dans les 72 heures après en avoir pris connaissance. Toutes les violations ne donnent pas lieu à notification, mais elles doivent être documentées. Une information des personnes concernées peut être requise en cas de risque élevé.
Le règlement européen sur l’IA ajoute des obligations variables selon les rôles et les cas d’usage. Tous les agents IA ne sont pas des systèmes à haut risque au sens de l’AI Act. Pour les systèmes qui relèvent de cette catégorie, l’article 26 prévoit notamment des exigences pour les déployeurs sur l’utilisation, la supervision humaine et le suivi. Il faut vérifier la qualification du système et le calendrier des dispositions applicables avant de transformer un principe de gouvernance en obligation réglementaire.
La question à poser au comité de direction est plus opérationnelle : qui peut arrêter l’agent, révoquer ses accès, enquêter sur ses actions et décider d’un signalement ? Si personne ne peut répondre, le dispositif est déjà fragile.
5. Une feuille de route de gouvernance praticable
| Horizon | Mesure | Preuve attendue |
|---|---|---|
| 0 à 30 jours | Identifier agents, comptes de service, outils et flux sortants | Registre initial et propriétaire nommé |
| 0 à 30 jours | Bloquer les accès excessifs et révoquer les secrets partagés | Liste de permissions et journal de révocation |
| 30 à 60 jours | Séparer connecteurs, exécution et publication ; filtrer les sorties | Schéma de flux validé et tests d’egress |
| 30 à 60 jours | Tester injections indirectes et dépendances compromises | Scénarios de test et résultats documentés |
| 60 à 90 jours | Mettre en place approbations ciblées, traçabilité et réponse à incident | Journaux corrélés, exercices et procédure d’arrêt |
Dans un audit, je demanderais aussi un test volontairement simple : injecter dans un jeu de données de démonstration une instruction demandant un export non autorisé, puis vérifier que l’outil refuse, quel que soit le texte produit par le modèle. Le test doit rester dans un environnement autorisé et utiliser des données fictives. C’est plus probant qu’une démonstration montrant uniquement que le modèle répond " je ne peux pas “.
Pour le pilotage, quelques indicateurs suffisent au départ : part des agents inventoriés, agents avec propriétaire, comptes à privilèges excessifs, flux sortants non approuvés, délai de révocation et pourcentage des tests d’injection bloqués au niveau des outils. On ne confondra pas ces indicateurs avec une garantie d’absence de risque.
Conclusion
L’autonomie des agents IA est utile lorsque l’entreprise peut délimiter leur champ d’action. Le point d’entrée d’un projet n’est donc pas forcément un nouveau modèle ou une sandbox plus sophistiquée. C’est souvent un inventaire des accès, des identités et des flux que l’on n’a jamais formalisés.
Pour une PME qui souhaite relier ses données Postgres, son ERP ou ses outils collaboratifs à une IA, cette gouvernance évite de reconstruire un système d’intégrations parallèles incontrôlées. Chez EloNeva, ce sujet s’inscrit dans la continuité d’un audit applicatif : identifier les frontières de confiance, sécuriser les connecteurs et garder une trajectoire exploitable par les équipes.
Définitions rapides
- Agent IA : application qui orchestre un modèle et des outils pour accomplir des actions.
- Shadow AI : utilisation ou déploiement d’IA en dehors des processus de gouvernance établis.
- Prompt injection indirecte : instructions malveillantes introduites dans du contenu que le modèle traite comme source d’information.
- Egress : trafic sortant d’un environnement vers d’autres réseaux ou services.
- Moindre privilège : attribution des seules permissions nécessaires à une tâche et pour une durée adaptée.